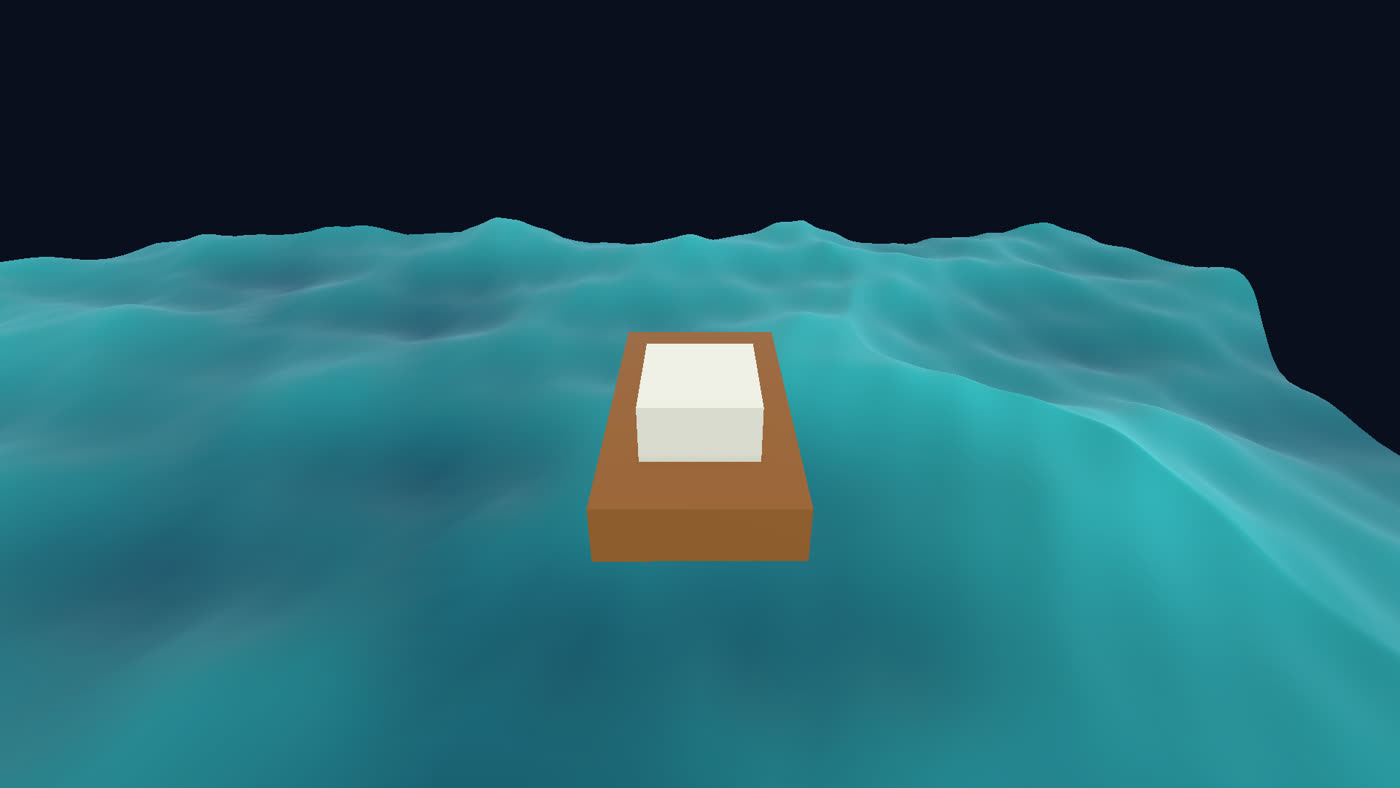
조선·해양 고객과 GPU 컴퓨팅 세미나를 준비하면서 컴퓨트 셰이더를 처음부터 다시 정리했습니다. 세미나는 HLSL 기초 한 시간, 컴퓨트 셰이더 네 세션으로 짰고, 마지막에는 GPU가 계산한 바다 위에 배가 떠서 항적을 남기는 데모로 끝납니다. 이 글은 그 슬라이드의 순서를 따라 컴퓨트 셰이더가 무엇이고, 어떻게 생겼고, 왜 쓰는지를 정리한 것입니다. 그림은 세미나 슬라이드에서 가져왔습니다.
셰이더인데 그리지 않는다
셰이더는 GPU에서 실행되는 작은 프로그램입니다. 보통은 그리는 데 씁니다. 버텍스 셰이더가 정점의 위치를 화면 좌표로 바꾸고, 래스터라이저가 삼각형 안쪽의 픽셀을 정하고, 프래그먼트 셰이더가 픽셀마다 색을 계산합니다. 이 순서는 고정되어 있고, 입력은 메시, 출력은 화면입니다.
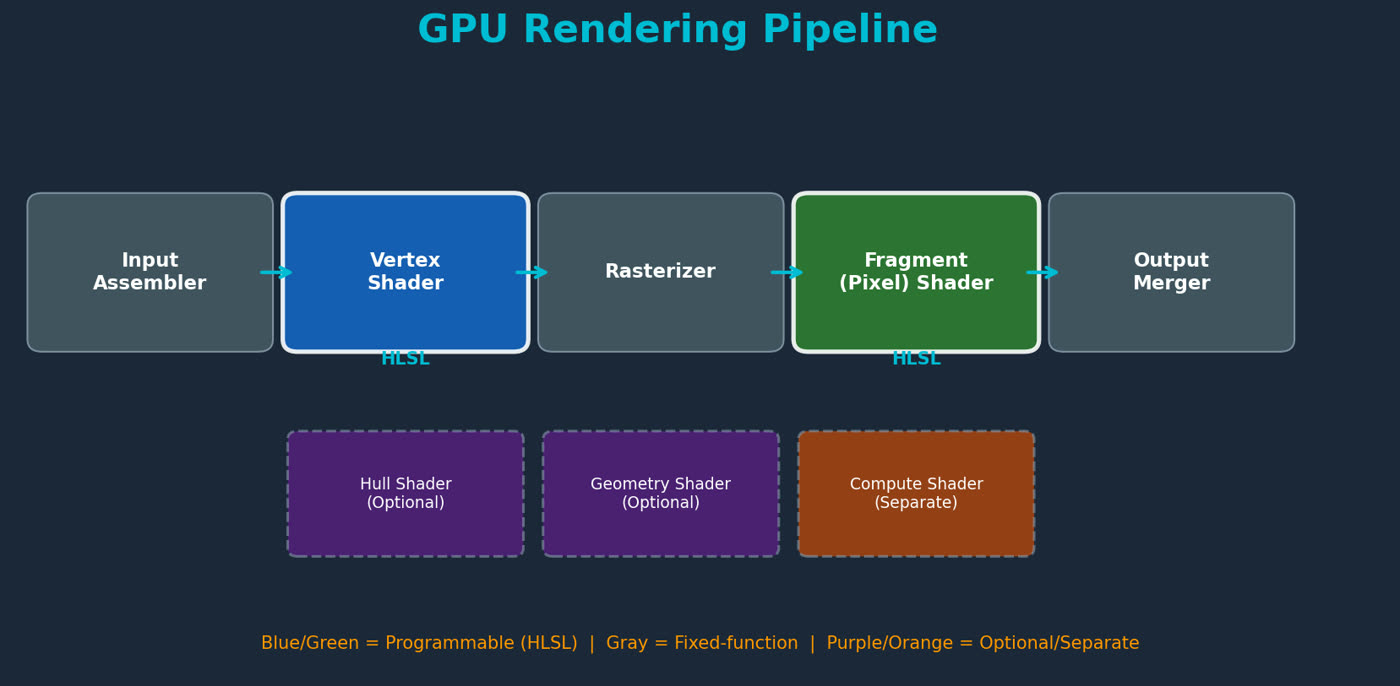
컴퓨트 셰이더는 이 파이프라인 바깥에 있습니다. 정해진 순서가 없고, 입력도 출력도 버퍼나 텍스처로 마음대로 정합니다. 그리는 일에 특화된 셰이더가 아니라 계산에 특화된 셰이더입니다. 그래서 물리, 시뮬레이션, 데이터 처리처럼 화면과 직접 관계없는 일에도 GPU를 쓸 수 있습니다. 이것을 GPGPU, 범용 GPU 계산이라고 부릅니다.
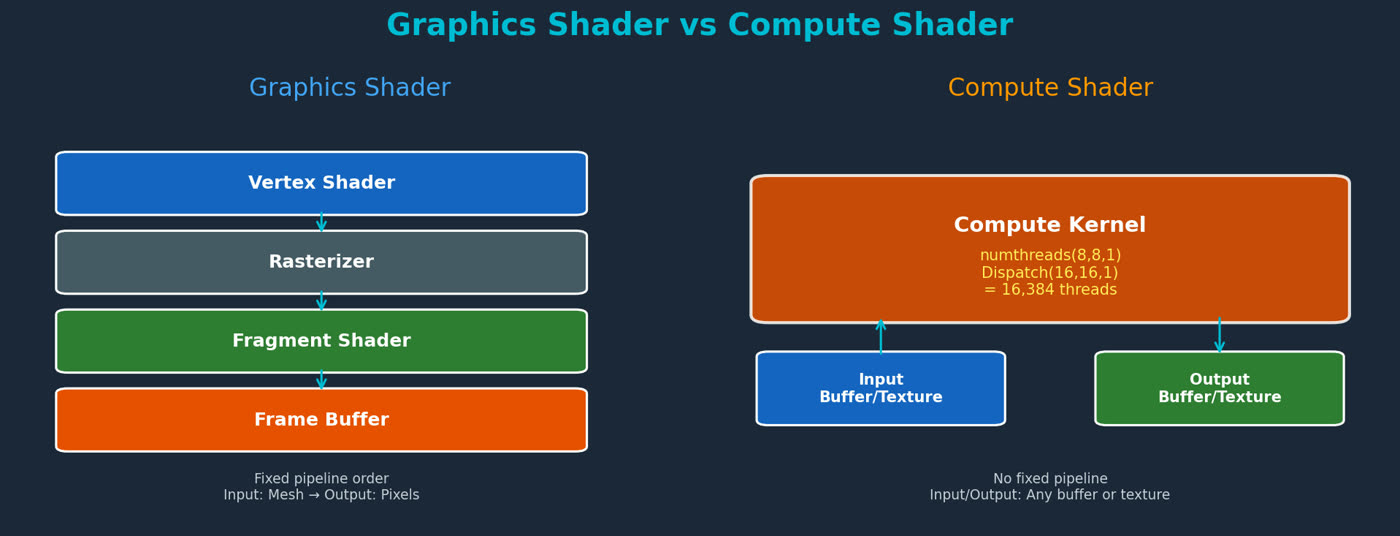
두 셰이더는 같은 HLSL로 씁니다. Unity에서는 .shader 파일 안의 HLSLPROGRAM 블록과 .compute 파일이 같은 문법을 공유합니다. 그래서 HLSL 기초를 한 시간 먼저 다룹니다. 데이터 타입은 float, float3, float4x4처럼 벡터와 행렬이 기본이고, 변수에 붙는 시멘틱은 GPU에게 이 값이 무엇인지 알려 주는 태그이고, 내장 함수는 sin, dot, lerp, normalize처럼 GPU에 최적화된 수학 도구입니다. C#과 가장 다른 점은 실행 방식입니다. C#은 한 줄씩 순서대로 실행하고, HLSL은 같은 함수가 수천 개 스레드에서 동시에 실행됩니다. 세미나에서는 이것을 요리사 한 명이 순서대로 요리하는 것과 요리사 만 명이 각자 한 접시씩 동시에 만드는 것으로 비유합니다.
왜 GPU인가
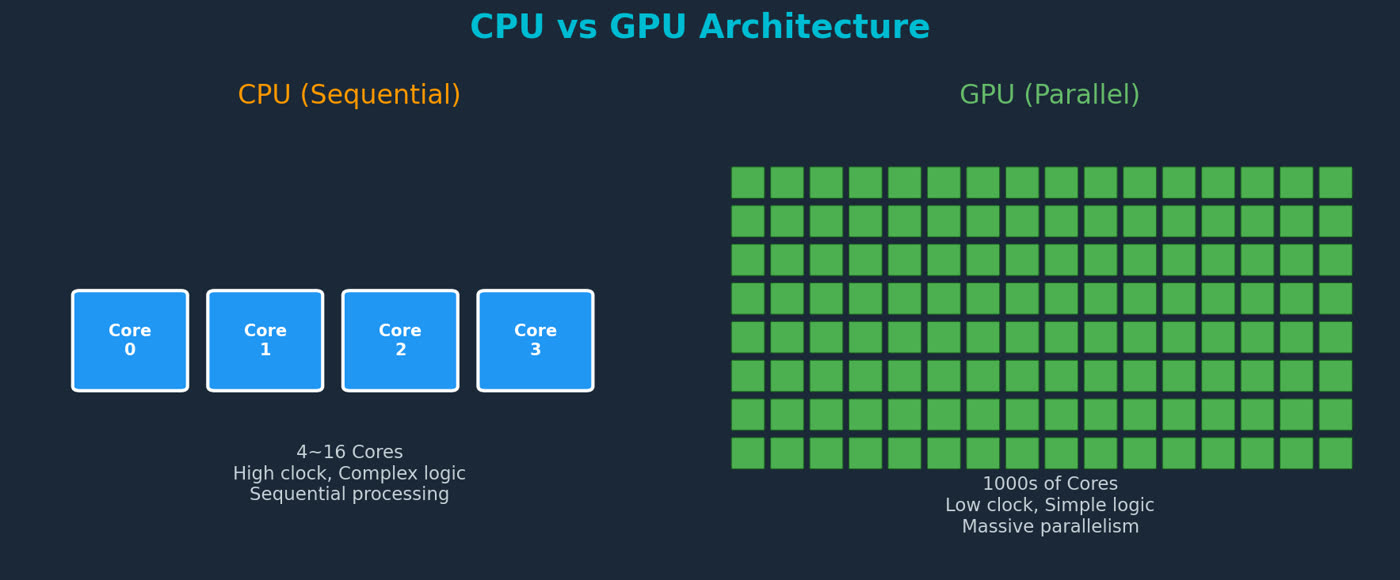
CPU는 코어가 4개에서 16개이고, 하나하나가 복잡한 분기와 순서가 있는 논리를 잘 처리합니다. GPU는 코어가 수천 개이고, 하나하나는 단순하지만 같은 연산을 대량의 데이터에 동시에 적용합니다. 그래서 판단 기준은 하나입니다. 같은 계산을 수만 개의 데이터에 반복해야 하면 GPU, 복잡한 논리를 소량의 데이터에 적용해야 하면 CPU입니다.
바다 한 장을 256×256 격자로 깔면 정점이 65,536개입니다. 매 프레임 이 점들에 같은 파도 공식을 적용해야 합니다. 정확히 GPU의 일입니다.
컴퓨트 셰이더의 구조
컴퓨트 셰이더는 세 가지로 이루어집니다. GPU에서 실행되는 함수인 커널, 커널을 실행하는 최소 단위인 스레드, 스레드를 묶은 스레드 그룹입니다. 아래는 세미나 세션 3에서 쓰는 커널을 그대로 옮긴 것입니다. 평평한 격자의 정점을 사인 파도로 밀어 올립니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
#pragma kernel CSSineDisplace

RWStructuredBuffer<float3> _Vertices;      // 결과를 쓰는 버퍼 (읽기+쓰기)
StructuredBuffer<float3>   _BaseVertices;  // 원래 위치 (읽기 전용)
float _Time, _Amplitude, _Frequency, _Speed;

[numthreads(256, 1, 1)]
void CSSineDisplace(uint3 id : SV_DispatchThreadID)
{
    float3 base = _BaseVertices[id.x];
    float y = _Amplitude * sin(base.x * _Frequency + _Time * _Speed);
    _Vertices[id.x] = float3(base.x, base.y + y, base.z);
}
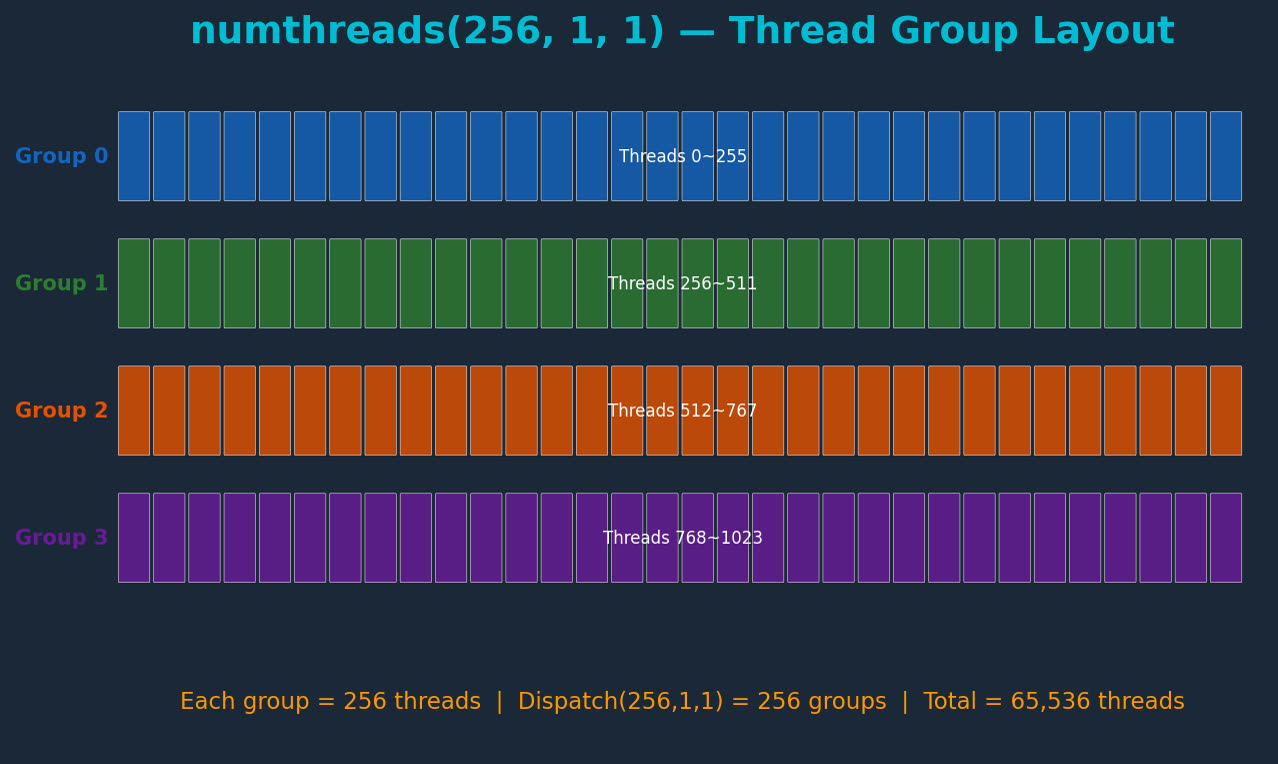
#pragma kernel이 커널을 선언합니다. 한 파일에 여러 커널을 둘 수 있습니다.[numthreads(256, 1, 1)]은 스레드 그룹 하나에 스레드 256개를 넣는다는 뜻입니다.SV_DispatchThreadID는 전체 스레드 중 이 스레드의 고유 번호입니다. GPU가 넣어 줍니다.
C#에서 Dispatch(256, 1, 1)을 부르면 그룹 256개가 뜨고, 그룹당 256개니까 스레드 65,536개가 동시에 이 함수를 실행합니다. 총 스레드 수는 항상 numthreads 곱하기 Dispatch입니다.
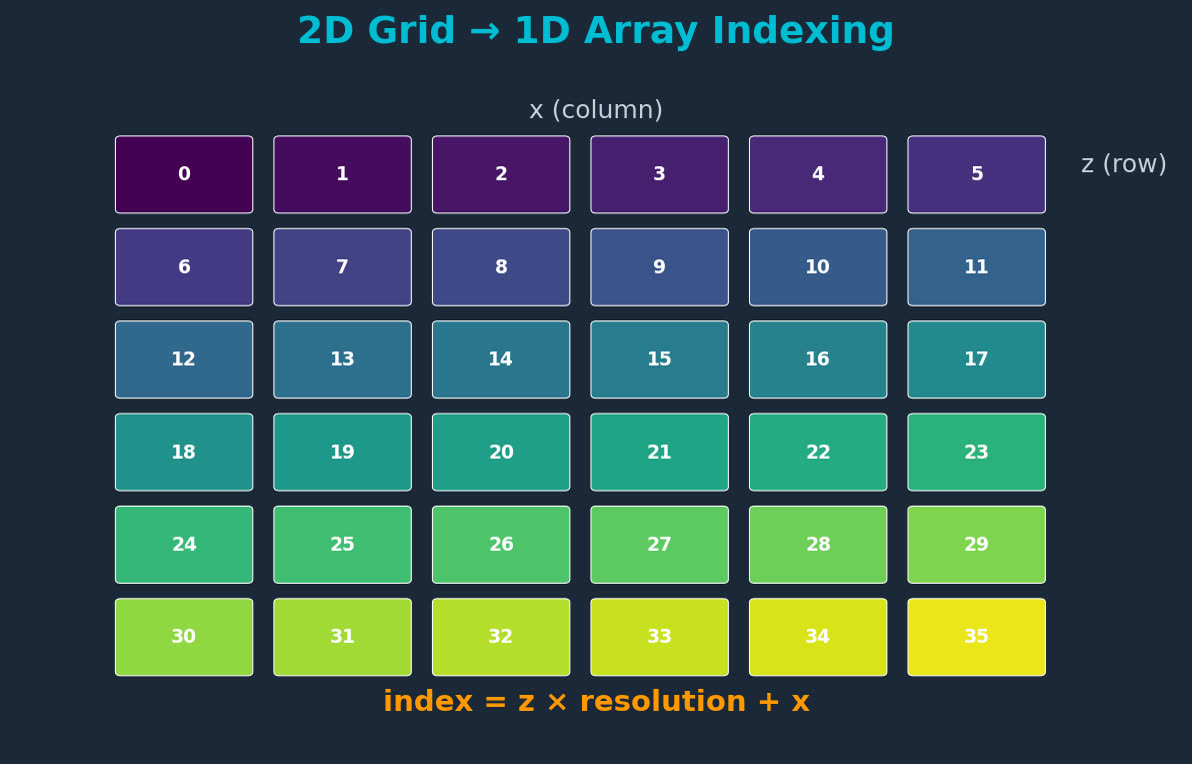
스레드 번호는 1차원으로 들어오는데 격자는 2차원입니다. 그래서 번호를 좌표로 바꾸는 나눗셈과 나머지 연산이 항상 붙습니다. 가로 열은 id.x % 해상도, 세로 행은 id.x / 해상도입니다. 이 약속은 C#에서 메시를 만들 때의 인덱스(z * 해상도 + x)와 정확히 같아야 합니다. 두 쪽이 다르면 GPU와 CPU가 다른 점을 가리킵니다.
데이터는 어디에 있나
CPU와 GPU는 메모리가 다릅니다. 둘 사이를 잇는 것이 버퍼입니다. C#에서 ComputeBuffer를 만들면 GPU 메모리가 잡히고, HLSL에서는 그것이 StructuredBuffer로 보입니다. 앞에 RW가 붙으면 읽고 쓸 수 있고, 없으면 읽기만 합니다.
위 커널에 버퍼가 두 개인 이유가 여기 있습니다. _BaseVertices는 원래 위치를 읽기만 하고, _Vertices에 결과를 씁니다. 하나로 합치면 이전 프레임의 변위 위에 다시 변위가 쌓여서 파도가 무한히 자랍니다. 세미나에서 이 둘을 일부러 합쳐 보면 바다가 하늘로 올라갑니다.
그리고 이 버퍼는 CPU로 돌아오지 않아도 됩니다. 렌더링 셰이더의 버텍스 함수에는 SV_VertexID라는 시멘틱이 있어서, 정점의 고유 번호로 같은 버퍼를 직접 읽을 수 있습니다. 컴퓨트 셰이더가 쓴 위치를 렌더링 셰이더가 바로 읽어 그립니다.
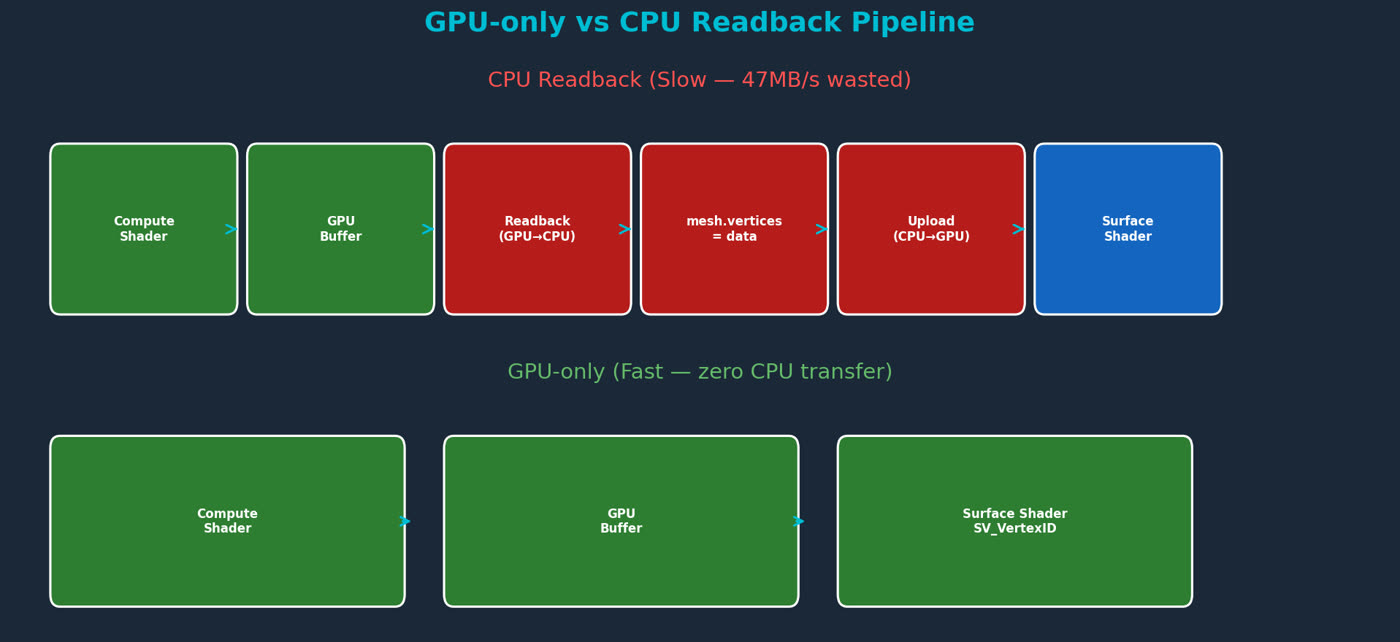
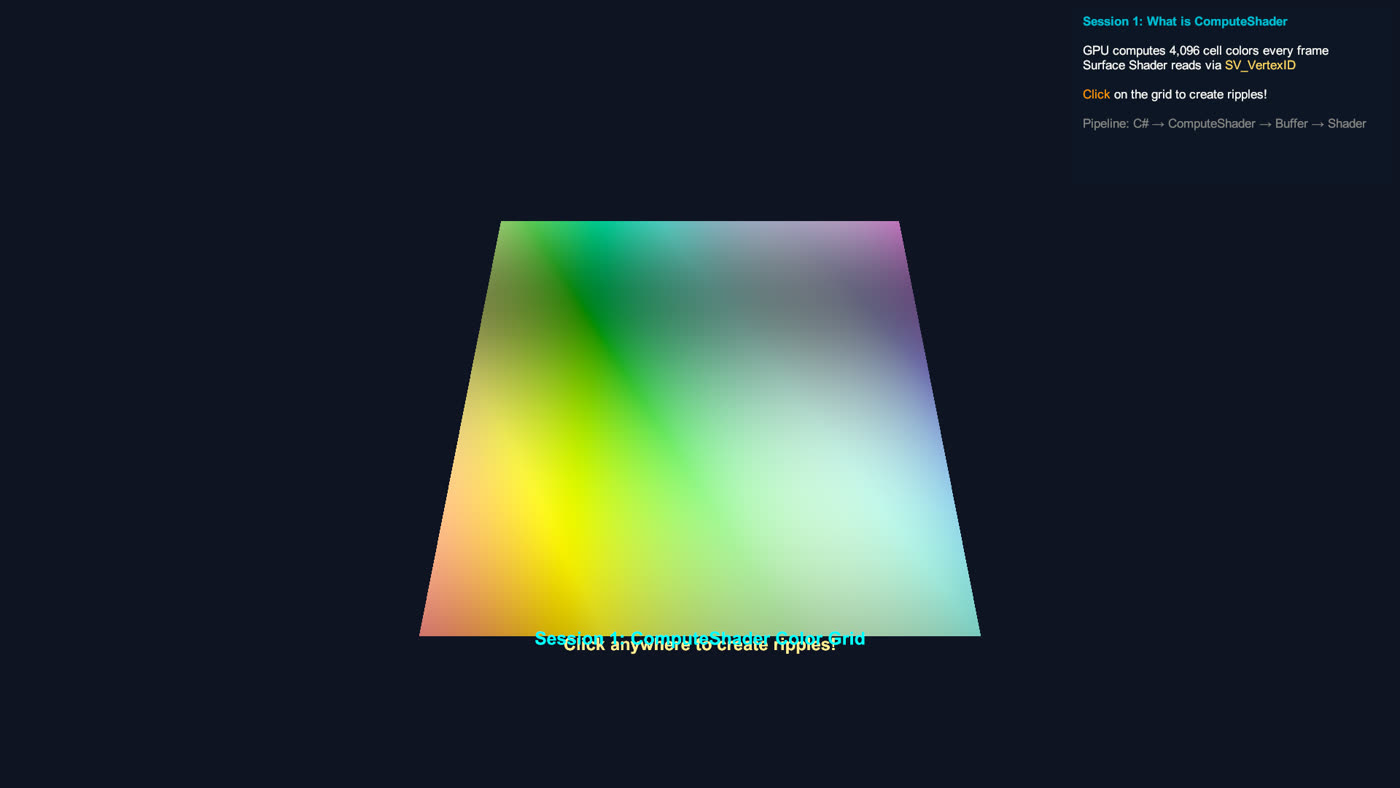
이것이 4시간 과정의 절반입니다. 컴퓨트 셰이더가 계산하고, 버퍼에 저장하고, 렌더링 셰이더가 읽는다. 데이터가 GPU를 떠나지 않는다. C#은 시작할 때 버퍼를 만들고 바인딩하는 일과, 매 프레임 파라미터를 넘기고 Dispatch를 부르는 일만 합니다. 세션 1의 데모는 이 구조로 64×64 격자의 색을 GPU에서 계산하고, 마우스를 클릭하면 그 자리에 물결이 퍼지게 합니다. CPU는 어디를 클릭했는지만 전달하고, 어떻게 보일지는 전부 GPU가 계산합니다.
숫자로 보는 차이
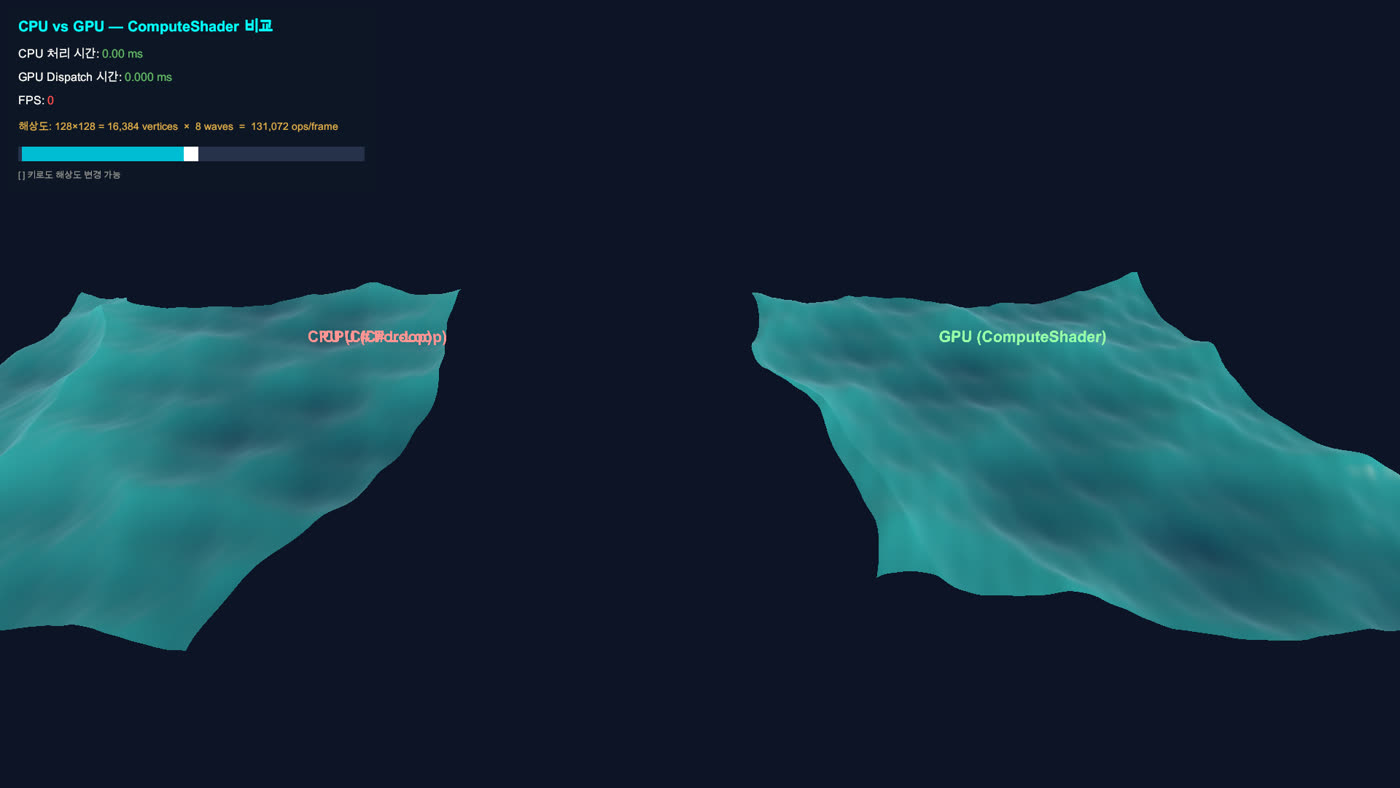
세션 2는 같은 파도 공식을 CPU와 GPU에서 각각 돌려 나란히 놓습니다. 공식은 사인 파도보다 현실적인 게르스트너 파도이고, 여덟 개를 겹칩니다. 정점 하나에 사인, 코사인, 제곱근이 들어간 연산이 약 40번이니 256×256에서는 한 프레임에 260만 번입니다. 격자를 올리면서 시간을 재면 이렇게 나옵니다.
| 격자 | 정점 수 | CPU 한 프레임 | GPU 한 프레임 |
|---|---|---|---|
| 64 × 64 | 4,096 | 약 0.5 ms | 약 0.02 ms |
| 128 × 128 | 16,384 | 약 4 ms | 약 0.05 ms |
| 256 × 256 | 65,536 | 약 20 ms | 약 0.1 ms |
| 512 × 512 | 262,144 | 약 100 ms | 약 0.3 ms |
CPU는 정점 수에 비례해 늘어나고, GPU는 코어가 남는 동안 거의 늘지 않습니다. 60fps의 한 프레임 예산은 16.7ms인데, 256×256에서 CPU는 파도만으로 예산을 넘습니다. 배도, 항적도, UI도 넣기 전입니다.
시간보다 중요한 차이가 하나 더 있습니다. CPU 방식은 계산한 정점을 매 프레임 mesh.vertices로 GPU에 다시 올려야 합니다. GPU 방식은 올릴 것이 없습니다. 그래서 세미나의 결론은 “GPU가 더 빠르다”가 아니라 “GPU에서 계산한 데이터는 GPU에서 읽어라”입니다.
메시를 코드로 만들면
세션 3은 이 파이프라인을 처음부터 끝까지 직접 만듭니다. 파일은 세 개입니다. 메시를 만들고 버퍼를 관리하고 Dispatch를 부르는 C#, 정점을 밀어 올리는 컴퓨트 셰이더, 버퍼를 읽어 그리는 렌더링 셰이더. 버퍼도 세 개입니다. 원래 위치, 변위된 위치, 그리고 법선.
법선이 따로 필요한 이유는 조명입니다. GPU가 정점을 움직였으니 면의 방향도 바뀌었는데, 메시에 저장된 법선은 평평할 때의 것입니다. 그래서 두 번째 커널이 이웃 정점의 차이로 법선을 다시 계산합니다. 변위 커널이 끝난 뒤에 법선 커널을 부르는 순서가 중요합니다.
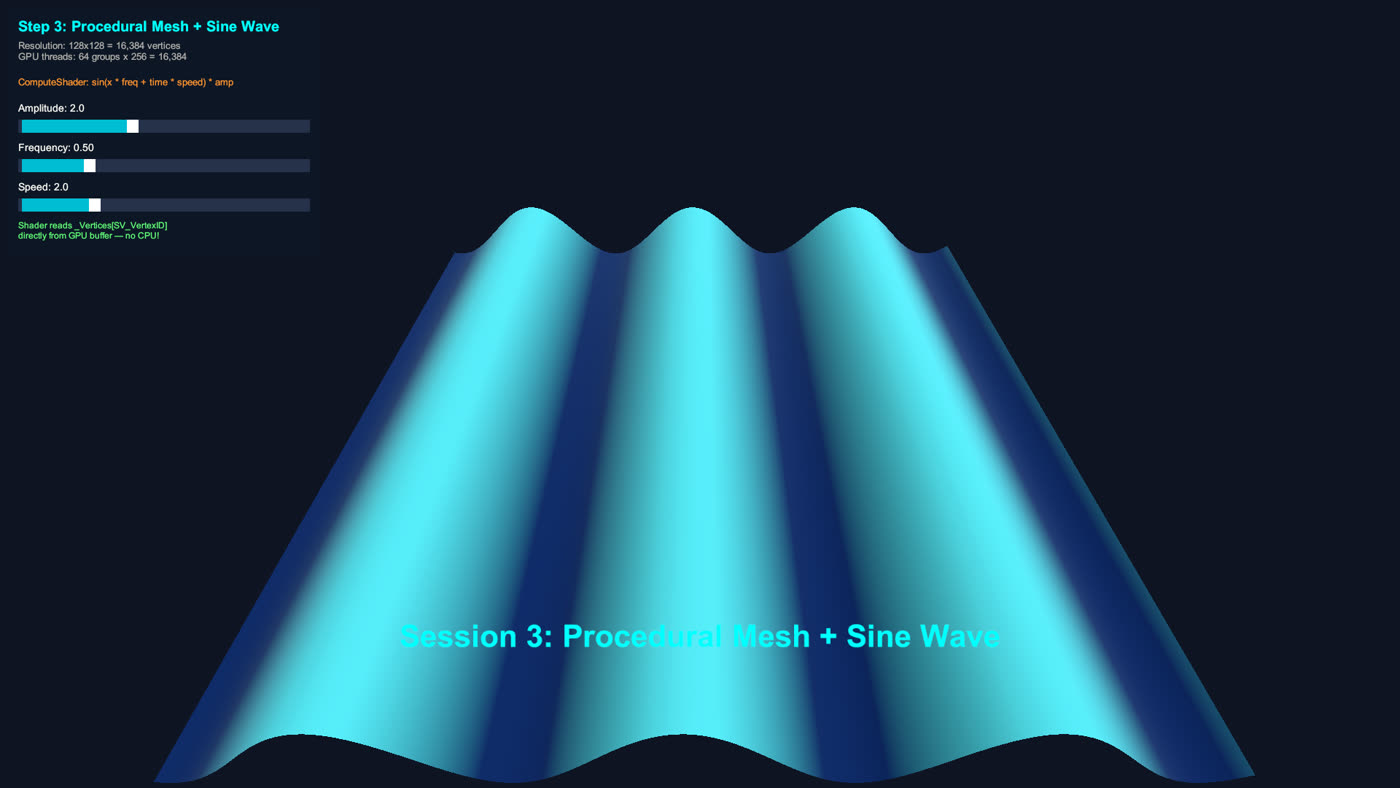
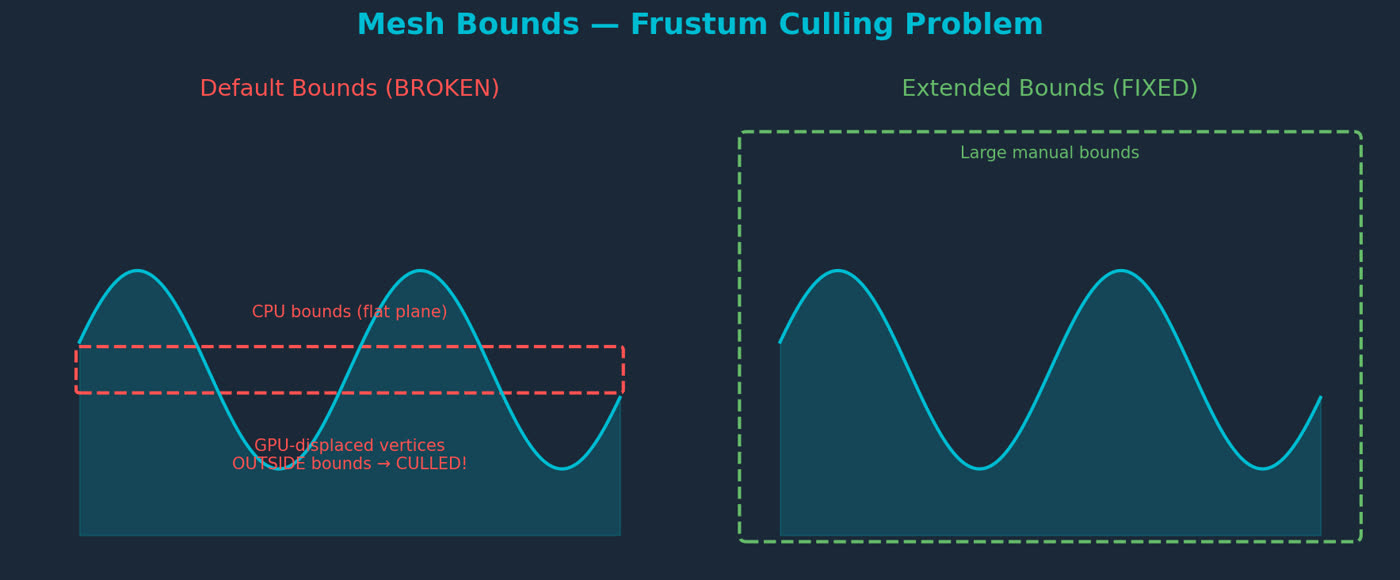
세미나에서 가장 많이 걸리는 함정은 메시 바운드입니다. Unity는 메시의 바운드로 카메라 밖 물체를 걸러 내는데, GPU가 정점을 움직여도 CPU 쪽 바운드는 그대로입니다. 그래서 카메라를 돌리면 바다가 사라집니다. 바운드를 충분히 크게 직접 잡아 줘야 합니다.
그런데 배는 CPU에 있습니다
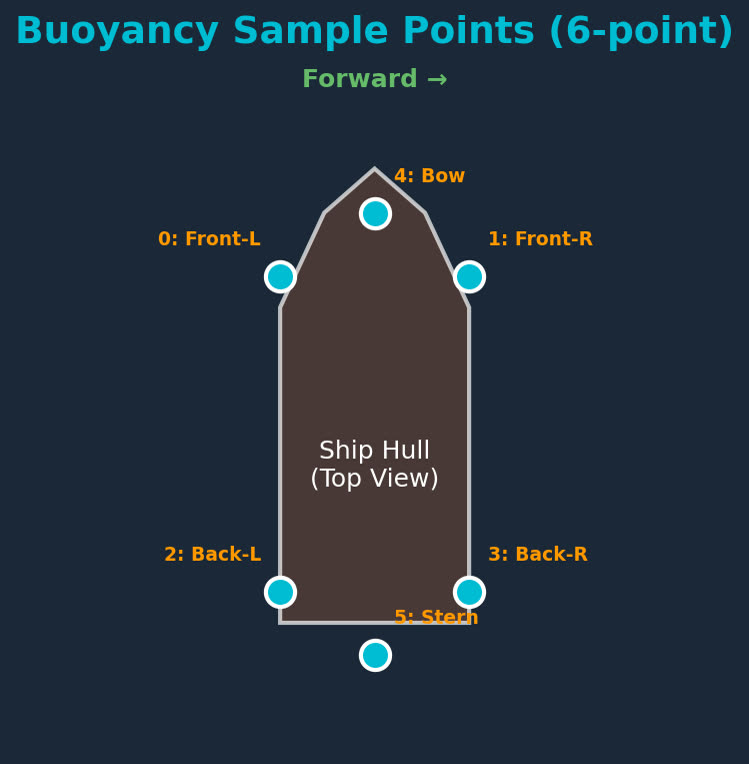
여기까지가 GPU 혼자 하는 일입니다. 세션 4는 GPU가 계산한 것을 CPU가 써야 할 때 생기는 문제를 다룹니다. 파도는 GPU가 계산합니다. 배는 Unity 물리 엔진, 즉 CPU 위에 있습니다. 배가 떠서 흔들리려면 선체 아래 몇 지점의 파도 높이를 CPU가 알아야 합니다.
GPU 버퍼를 CPU로 읽어 오는 AsyncGPUReadback이 있지만, 결과가 한두 프레임 늦게 도착하고, 여섯 점의 높이를 얻으려고 65,536개 정점을 통째로 복사해야 합니다. 배가 파도보다 늦게 반응하고 대역폭만 씁니다.
세미나의 답은 같은 공식을 두 곳에 두는 것입니다. GPU의 컴퓨트 셰이더는 게르스트너 공식으로 65,536개 정점을 움직이고, CPU의 C#은 같은 공식으로 선체 아래 여섯 점의 높이만 계산합니다. 같은 수식, 다른 규모입니다. 여섯 점이면 CPU 부하는 없는 것과 같고, 지연도 없습니다. 조건은 하나입니다. 파도의 파장, 진폭, 방향, 속도 파라미터가 두 쪽에서 정확히 같아야 합니다. 하나라도 어긋나면 배가 파도와 다른 곳에 떠 있습니다.
이 선택 기준은 부력 밖에서도 그대로 씁니다. 공식이 결정적이고 필요한 점이 적고 같은 프레임에 답이 필요하면 CPU에 공식을 복제합니다. 전체 결과가 필요하고 한두 프레임 늦어도 되면 읽어 옵니다. CPU에서 쓸 일이 없으면 GPU 안에서 끝냅니다.
정리
컴퓨트 셰이더는 렌더링 파이프라인 바깥에서 GPU를 계산기로 쓰는 셰이더입니다. 커널을 numthreads와 Dispatch로 수만 개 스레드에 펼치고, 버퍼로 데이터를 주고받고, 결과를 GPU 안에서 렌더링 셰이더가 바로 읽게 하면 CPU가 손댈 것이 거의 없어집니다. CPU가 결과를 써야 할 때는 읽어 오는 대신 같은 공식을 작은 규모로 복제하는 쪽이 대부분 맞습니다.
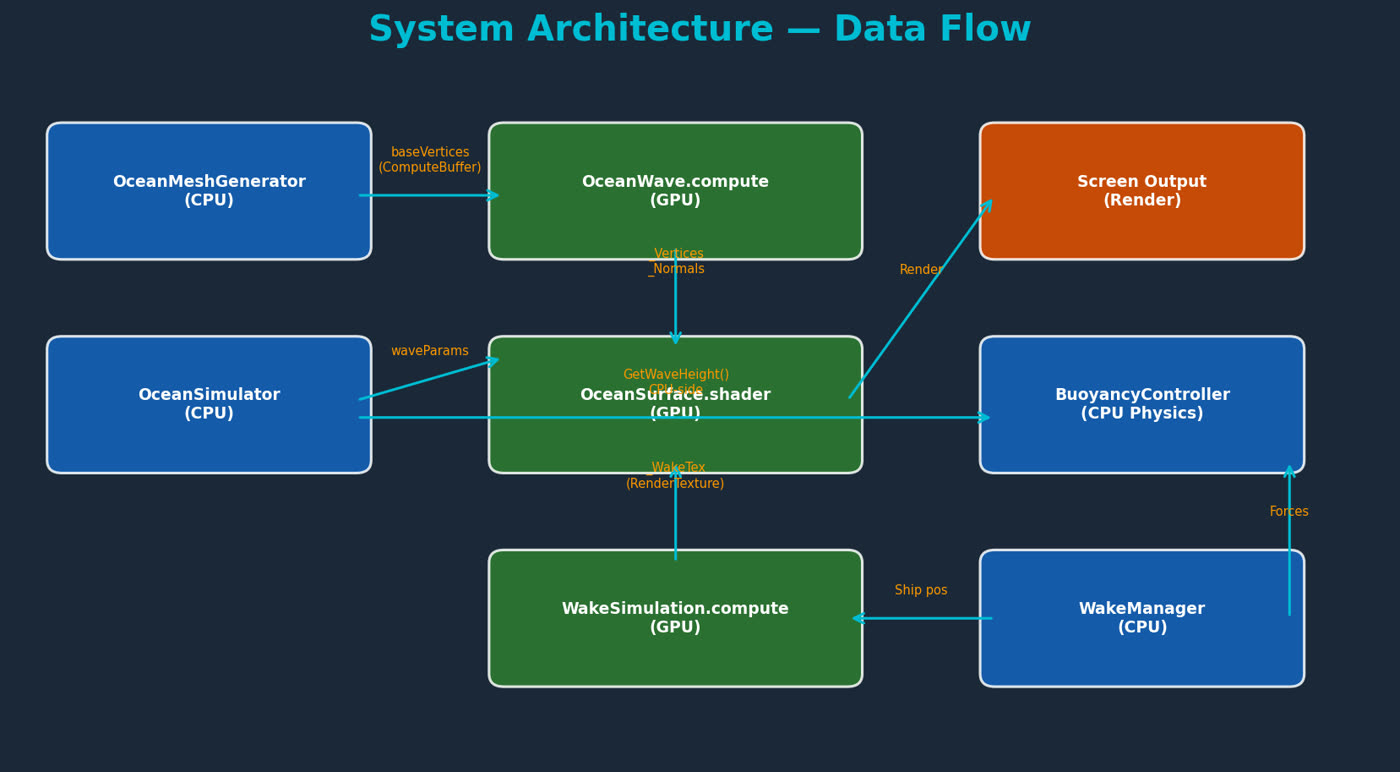
세미나는 여기서 배가 지나간 자리에 항적이 남는 데모로 끝나는데, 항적은 또 다른 컴퓨트 셰이더가 텍스처에 도장을 찍고 흐리는 방식입니다. 그 이야기와, 조선소 블록 하나에 들어가는 부품 십만 개를 드로우콜 하나로 그리는 GPU 인스턴싱은 다음 글에서 다룹니다.